Domain klebekraft.de kaufen?
Wir ziehen mit dem Projekt
klebekraft.de um.
Sind Sie am Kauf der Domain
klebekraft.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain klebekraft.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Barbara Proschak: Material - Anhaftung - variabel, Fachbücher von Barbara Proschak, Barbara Kohout ProschakDas Buch "Material - Anhaftung - variabel" von Barbara Proschak bietet einen tiefen Einblick in die künstlerische Praxis der Autorin, die sich über ein Jahrzehnt erstreckt. Proschak untersucht die Grenzen der Fotografie durch ihre einzigartigen fotografischen Arrangements, die sowohl Einzelwerke als auch Serien und Tableaus umfassen. Die zentrale Thematik des Buches ist die Variabilität, die sich wie ein roter Faden durch ihr Schaffen zieht. In ihren Stillleben und fotografischen Kompositionen werden gegensätzliche Erscheinungsformen und Zusammenhänge beleuchtet, wodurch die Unterschiede zwischen Menschen, Objekten und Materialien sichtbar gemacht werden. Proschaks akribische Herangehensweise an die Kunst zeigt, wie kreative Prozesse entstehen und sich entfalten. Dieses Buch ist nicht nur eine Sammlung von Bildern, sondern ein Prozess, der die Leser*innen dazu einlädt, die Vielfalt der künstlerischen Ausdrucksformen zu entdecken.43,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
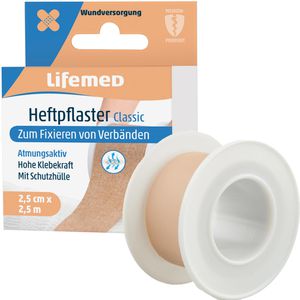
Lifemed Fixierpflaster Heftpflaster Classic, Rolle, hohe Klebekraft, 2,5m x 2,5cmWiderstandsfähiges Fixierpflaster mit besonders starker Klebekraft Mit Seitenscheiben aus Kunststoff Zur Fixierung von Verbänden & Wundauflagen Merkmale: Beschaffenheit: stark klebend Breite: 2,5 cm Farbe: beige weitere Produktinformationen: Inhalt: 2.5m,3,11 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Zukunft - Glück - Zusammenhalt, Sachbücher von Reinhold PoppDas Buch "Zukunft - Glück - Zusammenhalt" bietet eine tiefgehende Analyse der Rahmenbedingungen, die die Lebensqualität in Deutschland und Österreich beeinflussen. In 25 Essays werden verschiedene gesellschaftliche, ökonomische, technische und politische Aspekte beleuchtet, die entscheidend für das individuelle und kollektive Glück sind. Der Autor, Univ.-Prof. Dr. Reinhold Popp, nutzt seine Expertise in der Zukunfts- und Innovationsforschung, um realistische Perspektiven auf die gegenwärtigen Herausforderungen und zukünftigen Entwicklungen zu skizzieren. Die Essays sind wissenschaftlich fundiert, jedoch allgemein verständlich formuliert, sodass sie sowohl für Fachleute als auch für interessierte Laien zugänglich sind. Themen wie familiäres Zusammenleben, Arbeitswelt, Bildungssystem und soziale Marktwirtschaft werden kritisch betrachtet und mit einem Blick auf die Zukunft diskutiert. Dieses Buch ist eine wertvolle Lektüre für alle, die sich mit den komplexen Zusammenhängen von Glück und Lebensqualität auseinandersetzen möchten.44,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Barbara Proschak: Material - Anhaftung - variabel, Fachbücher von Barbara Proschak, Barbara Kohout ProschakDas Buch "Material - Anhaftung - variabel" von Barbara Proschak bietet einen tiefen Einblick in die künstlerische Praxis der Autorin, die sich über ein Jahrzehnt erstreckt. Proschak untersucht die Grenzen der Fotografie durch ihre einzigartigen fotografischen Arrangements, die sowohl Einzelwerke als auch Serien und Tableaus umfassen. Die zentrale Thematik des Buches ist die Variabilität, die sich wie ein roter Faden durch ihr Schaffen zieht. In ihren Stillleben und fotografischen Kompositionen werden gegensätzliche Erscheinungsformen und Zusammenhänge beleuchtet, wodurch die Unterschiede zwischen Menschen, Objekten und Materialien sichtbar gemacht werden. Proschaks akribische Herangehensweise an die Kunst zeigt, wie kreative Prozesse entstehen und sich entfalten. Dieses Buch ist nicht nur eine Sammlung von Bildern, sondern ein Prozess, der die Leser*innen dazu einlädt, die Vielfalt der künstlerischen Ausdrucksformen zu entdecken.43,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Lifemed Fixierpflaster Heftpflaster Classic, Rolle, hohe Klebekraft, 2,5m x 2,5cmWiderstandsfähiges Fixierpflaster mit besonders starker Klebekraft Mit Seitenscheiben aus Kunststoff Zur Fixierung von Verbänden & Wundauflagen Merkmale: Beschaffenheit: stark klebend Breite: 2,5 cm Farbe: beige weitere Produktinformationen: Inhalt: 2.5m,3,11 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.